ИССЛЕДОВАНИЕ ЭФФЕКТИВНОСТИ МЕТОДОВ РАСПОЗНАВАНИЯ ИГРОВЫХ НОМЕРОВ ХОККЕИСТОВ НА ИЗОБРАЖЕНИЯХ
1Московский политехнический университет, магистрант кафедры «Прикладная математика и информатика»
2Московский политехнический университет, кандидат экономических наук, профессор кафедры «Прикладная математика и информатика»
Аннотация
Ошибки распознавания номеров затрудняют анализ хоккейных матчей. На 3 396 областях сравнены CRNN, ViTSTR и PARSeq-Tiny при уменьшении и размытии изображений. Оценён вклад качества изображения и согласия моделей в отбор ответов при равном покрытии. При уменьшении вдвое преимущество сочетания признаков при покрытии 10 и 20 % не подтверждено условными 95%-ми доверительными интервалами. Калибровочный порог комбинированной оценки PARSeq-Tiny дал покрытие 73,4 % при 0,80 % ошибок.
Ключевые слова: калибровка уверенности, качество изображений, компьютерное зрение, надёжность распознавания, низкое разрешение, отказ от ответа, размытие, распознавание номеров, хоккей
Рубрика: 05.00.00 ТЕХНИЧЕСКИЕ НАУКИ
Библиографическая ссылка на статью:
Демешко Е.М., Суворов С.В. Исследование эффективности методов распознавания игровых номеров хоккеистов на изображениях // Современные научные исследования и инновации. 2026. № 10 [Электронный ресурс]. URL: https://web.snauka.ru/issues/2026/10/105277 (дата обращения: 03.11.2026).
Введение
Игровой номер служит для идентификации хоккеиста при анализе видеозаписи [1, с. 3235] [2, с. 653]. Малый размер цифр и смаз снижают точность их распознавания. Отказ от ненадёжных ответов сокращает число ошибок [3, с. 2], однако уверенность модели требует калибровки [4, с. 1], а качество отбора может изменяться при смене источника данных [5, с. 1].
Цель исследования состоит в сравнении устойчивости распознавания к уменьшению и размытию изображений и эффективности отбора ответов по уверенности, длине строки, качеству изображения и согласию моделей. Отбор оценивается при одинаковом покрытии и при пороге, выбранном по калибровочным данным.
Материалы и методы
Основная выборка из набора Hockey Player Jersey Numbers [6] составила 3 396 областей номеров из 2 892 изображений. Экспортные варианты одного исходного имени выбирались по приоритету частей: тестовая, проверочная, обучающая, затем по имени файла. Эталон определялся по исходному коду класса и словарю набора; метки и рамки сохранены. Неразмеченные изображения исключены. Дополнительный срез включает 836 областей хоккейных видеокадров.
Сформированы 2 456 групп, в том числе 157 в дополнительном срезе. Учитывались исходный кадр, видеосерия, пара соперников, совпадения пикселей и 64-разрядный перцептивный хеш полных изображений с допуском четыре бита. Применялась пятикратная групповая перекрёстная проверка с тремя повторениями. На обучение, проверку, калибровку и тест отводилось около 50, 10, 20 и 20 % групп; каждый объект тестировался один раз за повторение.
Предварительно обученные CRNN [7, с. 2], ViTSTR [8, с. 6] и PARSeq-Tiny [9, с. 183] из реализации [10] дообучались с AdamW. Шаг и коэффициент регуляризации составляли 10⁻⁴; шаг уменьшался по косинусному закону до 10⁻⁵. Размер пакета составлял 32 изображения, обучение ограничивалось 12 эпохами и прекращалось после четырёх эпох без роста проверочной точности. Выбирались параметры с её максимумом. Применялись случайные геометрические и цветовые преобразования. Изображения масштабировались по осям до 128 × 32 пикселей.
Семь условий включали исходное изображение; уменьшение сторон до 75, 50 и 25 % с восстановлением размера; горизонтальное гауссово размытие при σ = 0,03h и 0,06h; уменьшение до 50 % с размытием σ = 0,03h. Здесь h обозначает исходную высоту области. Искажения вносились до входного масштабирования.
Уверенность вычислялась как среднее геометрическое вероятностей выбранных символов по всему пути выравнивания CRNN и до символа конца строки включительно у ViTSTR и PARSeq-Tiny. Сопоставлялись исходная уверенность, её монотонная сигмоидальная калибровка и пять вариантов логистической регрессии с квадратичной регуляризацией. Регрессия учитывала разные сочетания признаков: логарифм отношения шансов уверенности, признак двузначного ответа, логарифм высоты области, логарифмически преобразованную нормированную дисперсию лапласиана, стандартное отклонение яркости и долю совпадений с ответами двух других моделей. Комбинированная оценка использовала все признаки.
Параметры нормировки и регрессий определялись отдельно в каждом разбиении по числовым ответам калибровочной части всех семи условий; суммарный вес вариантов одного изображения равен единице. Такая калибровка могла менять общий порядок объединённых тестовых ответов. Эталон и тип искажения тестового объекта в признаки не входили; равенства оценок разрешались фиксированным порядком без эталонов.
Верным считалось полное совпадение строки с эталоном; принимались ответы из одной или двух цифр. Покрытие C и доля ошибок R определялись как
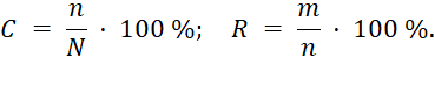
где N, n и m обозначают число объектов, принятых ответов и ошибок среди них. При n = 0 величина R не определена. Для покрытия около 10 и 20 % принимались 340 и 680 ответов из 3 396, с округлением вверх.
Порог минимизировал на калибровочной части удельные затраты
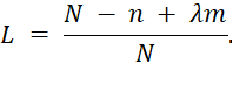
при стоимости ручной проверки 1 и принятия ошибочного номера λ = 20. Он применялся к тесту без изменений. Полной ручной проверке соответствует L = 1; её ошибки и стоимость вычислений не учитываются.
Внешняя проверка включала 375 изображений игроков одного матча из хоккейной части Nady [11]. Она не использовалась для обучения и настройки; числовые метки сохранены, номер дополнительно не локализовался. Показатели усреднялись по трём повторениям. Условные 95%-е доверительные интервалы получены по 2000 повторным выборкам групп [12, с. 170] при фиксированных параметрах моделей и разметке. Сравнения имели поисковый характер, без поправки на множественность.
Результаты и обсуждение
Основные результаты рассчитаны по всем 3 396 областям. В таблице 1 приведены средние точности и стандартные отклонения по трём повторениям. Наибольшее снижение точности всех моделей наблюдалось при уменьшении сторон до 25 %.
Таблица 1. Точность распознавания на 3 396 областях номеров, %
| Условие |
CRNN |
ViTSTR |
PARSeq-Tiny |
| Исходное изображение |
86,5 ± 0,2 |
90,9 ± 0,2 |
91,5 ± 0,4 |
| Уменьшение до 75 % |
83,9 ± 0,3 |
88,5 ± 0,1 |
89,0 ± 0,4 |
| Уменьшение до 50 % |
78,9 ± 0,3 |
83,3 ± 0,2 |
83,7 ± 0,4 |
| Уменьшение до 25 % |
72,8 ± 0,3 |
75,0 ± 0,1 |
75,5 ± 0,2 |
| Размытие σ = 0,03h |
84,6 ± 0,1 |
89,1 ± 0,2 |
89,6 ± 0,2 |
| Размытие σ = 0,06h |
74,6 ± 0,3 |
80,0 ± 0,2 |
81,1 ± 0,3 |
| Уменьшение до 50 % и размытие σ = 0,03h |
78,4 ± 0,2 |
82,3 ± 0,4 |
82,7 ± 0,3 |
При двукратном уменьшении влияние признаков оценивалось при одинаковых 680 принятых ответах (таблица 2). У CRNN средняя доля ошибок комбинированной оценки ниже, чем исходной уверенности; у ViTSTR и PARSeq-Tiny она выше.
Таблица 2. Доля ошибок среди 680 принятых ответов из 3 396, %
| Вариант оценки надёжности |
CRNN |
ViTSTR |
PARSeq-Tiny |
| Уверенность |
1,27 |
0,54 |
0,74 |
| Монотонная калибровка |
0,88 |
0,69 |
0,54 |
| Регрессия по уверенности |
0,98 |
0,74 |
0,54 |
| Уверенность и длина |
0,98 |
0,64 |
0,64 |
| Уверенность, длина и качество |
0,88 |
0,78 |
0,74 |
| Уверенность, длина и согласие |
0,74 |
0,69 |
0,64 |
| Комбинированная оценка |
0,64 |
0,78 |
0,78 |
Рисунок 1 показывает отбор при двукратном уменьшении. Вариант с учётом качества объединяет уверенность, длину и качество; комбинированная оценка добавляет согласие. Точки соответствуют средним, отрезки показывают стандартные отклонения по трём повторениям.

Рисунок 1. Зависимость доли ошибок от покрытия на выборке из 3 396 областей номеров
В таблице 3 из доли ошибок комбинированной оценки вычтена доля ошибок уверенности. Условные 95%-е доверительные интервалы включают ноль: преимущество при покрытии около 10 и 20 % на всей выборке не подтверждено.
Таблица 3. Разности долей ошибок на всей выборке, п. п.
|
Модель |
340 ответов (около 10 %) |
680 ответов (около 20 %) |
| CRNN |
−0,20 |
−0,64 |
| ViTSTR |
0,49 |
0,25 |
| PARSeq-Tiny |
0,39 |
0,05 |
В таблице 4 приведён пороговый отбор при λ = 20 на двукратно уменьшенных изображениях. Порог выбран по калибровочным данным. Показатели усреднялись раздельно; L вычислялось по количествам ответов и ошибок.
Таблица 4. Показатели порогового отбора на всей выборке при λ = 20
| Модель |
Оценка |
Принято, % |
Ошибки, % |
Затраты L |
| CRNN |
Уверенность |
46,81 |
2,01 |
0,720 |
| CRNN |
С учётом качества |
53,53 |
1,37 |
0,612 |
| CRNN |
Комбинированная |
71,32 |
0,96 |
0,424 |
| ViTSTR |
Уверенность |
71,49 |
0,97 |
0,425 |
| ViTSTR |
С учётом качества |
74,01 |
1,19 |
0,437 |
| ViTSTR |
Комбинированная |
73,40 |
0,94 |
0,403 |
| PARSeq-Tiny |
Уверенность |
71,47 |
1,23 |
0,462 |
| PARSeq-Tiny |
С учётом качества |
72,27 |
0,92 |
0,411 |
| PARSeq-Tiny |
Комбинированная |
73,40 |
0,80 |
0,384 |
Комбинированная оценка дала наименьшие средние L среди вариантов таблицы 4. Для PARSeq-Tiny покрытие 73,40 % при доле ошибок 0,80 % оставляет около 26,6 % объектов для ручной проверки.
На 836 областях при уменьшении вдвое комбинированная оценка CRNN дала 14,3 % ошибок против 27,0 % по уверенности (168 ответов). Интервал разности [−18,2; −7,8] п. п. не включает ноль; у ViTSTR и PARSeq-Tiny включает.
На внешних изображениях игроков точность CRNN, ViTSTR и PARSeq-Tiny составила 6,8, 5,9 и 9,7 % соответственно, в среднем по 15 обученным моделям каждой архитектуры. Одновременная смена источника и области вокруг номера не позволяет изолировать перенос на новые матчи. Локализация номера на полном кадре и естественные искажения не исследовались. Независимость всех матчей не гарантирована; интервалы не учитывают ошибки разметки и вариабельность нового обучения.
Заключение
Уменьшение и размытие изображений снижали точность всех трёх распознавателей. На 3 396 областях преимущество комбинированной оценки при покрытии около 10 и 20 % не подтверждено. При пороге, выбранном по калибровочным данным для λ = 20, PARSeq-Tiny обеспечил покрытие 73,40 % при 0,80 % ошибок и L = 0,384. Применение к новым матчам требует независимой проверки на сопоставимо выделенных областях номеров.
Библиографический список
- Koshkina M., Elder J. H. A General Framework for Jersey Number Recognition in Sports Video // Proceedings of the IEEE/CVF CVPR Workshops. 2024. P. 3235-3244.
- Nady A., Hemayed E. E. Player Identification in Different Sports // Proceedings of VISIGRAPP 2021. Vol. 5: VISAPP. 2021. P. 653-660. DOI: 10.5220/0010341706530660.
- Geifman Y., El-Yaniv R. Selective Classification for Deep Neural Networks // Advances in Neural Information Processing Systems. 2017. URL: https://arxiv.org/abs/1705.08500 (дата обращения: 30.10.2026).
- Slossberg R., Anschel O., Markovitz A. et al. On Calibration of Scene-Text Recognition Models // arXiv. 2020. № 2012.12643. URL: https://arxiv.org/abs/2012.12643 (дата обращения: 29.10.2026).
- Liang H., Peng L., Sun J. Selective Classification Under Distribution Shifts // Transactions on Machine Learning Research. 2024. URL: https://arxiv.org/abs/2405.05160 (дата обращения: 29.10.2026).
- hockey vision. Hockey Player Jersey Numbers [Электронный ресурс]. Roboflow. URL: https://universe.roboflow.com/hockey-vision/hockey-player-jersey-numbers-h1gd7 (дата обращения: 30.10.2026).
- Shi B., Bai X., Yao C. An End-to-End Trainable Neural Network for Image-based Sequence Recognition and Its Application to Scene Text Recognition // arXiv. 2015. № 1507.05717. DOI: 10.48550/arXiv.1507.05717.
- Atienza R. Vision Transformer for Fast and Efficient Scene Text Recognition // arXiv. 2021. № 2105.08582. DOI: 10.48550/arXiv.2105.08582.
- Bautista D., Atienza R. Scene Text Recognition with Permuted Autoregressive Sequence Models // Computer Vision. ECCV 2022. Cham: Springer, 2022. P. 178-196. DOI: 10.1007/978-3-031-19815-1_11.
- Bautista D. Scene Text Recognition Model Hub [Электронный ресурс]. URL: https://github.com/baudm/parseq (дата обращения: 29.10.2026).
- Nady A. Sports-Player-Identification. Ice hockey subset [Электронный ресурс]. URL: https://github.com/ahmed-nady/Sports-Player-Identification (дата обращения: 30.10.2026).
- Efron B., Tibshirani R. J. An Introduction to the Bootstrap. New York: Chapman & Hall, 1993.
Все статьи автора «Демешко Егор Михайлович»
© Если вы обнаружили нарушение авторских или смежных прав, пожалуйста, незамедлительно сообщите нам об этом по электронной почте.